
































Pengolahan Data dalam Metodologi Penelitian

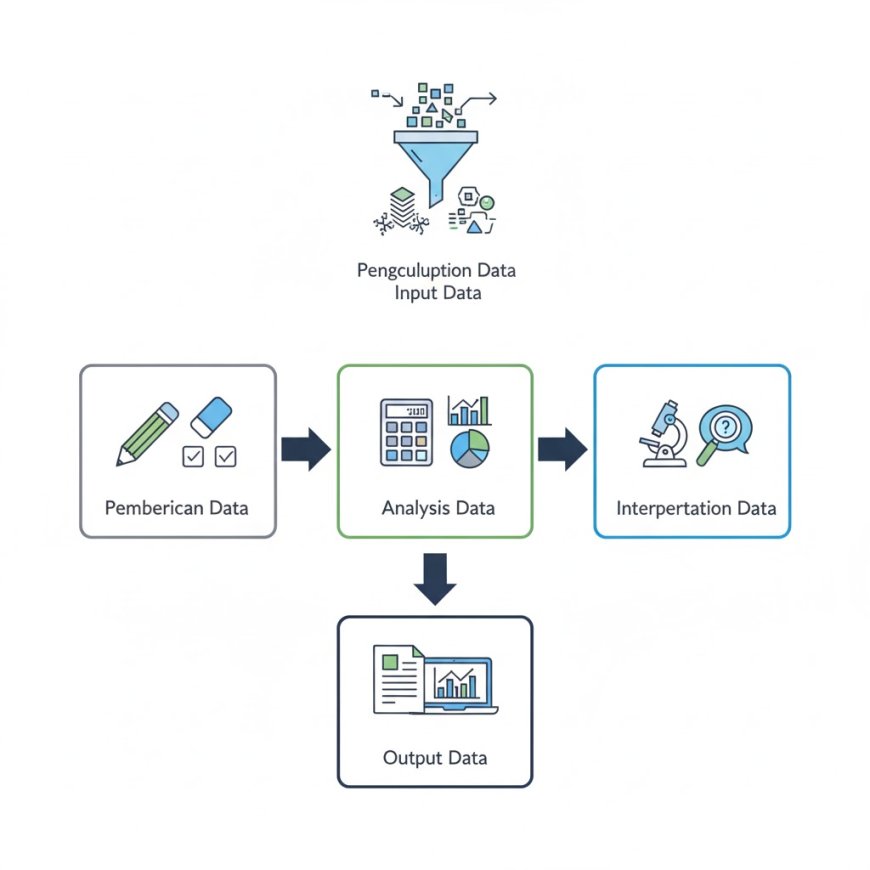
Pengolahan Data dalam Metodologi Penelitian: Pondasi Ilmiah yang Sering Diabaikan
Bayangkan Anda sudah mengumpulkan ratusan data hasil survei, observasi, atau eksperimen. Semua tampak lengkap, tapi ketika sampai pada tahap analisis, hasilnya tidak sesuai harapan. Mengapa hal ini sering terjadi? Jawabannya sederhana namun krusial proses pengolahan data belum dilakukan dengan benar. Dalam dunia riset, data mentah bagaikan bahan baku masakan: tanpa pengolahan yang tepat, hasil akhirnya tidak akan enak, bahkan bisa beracun bagi validitas penelitian.
Setiap peneliti, baik pemula maupun ahli, perlu memahami bahwa pengolahan data dalam metodologi penelitian bukan sekadar langkah teknis. Ia adalah jantung dari proses ilmiah mengubah data acak menjadi informasi bermakna yang bisa menjawab pertanyaan penelitian. Namun, di balik tampilan yang sistematis, terdapat banyak kesalahan umum: data tidak dibersihkan, variabel tidak dikodekan dengan konsisten, atau metode statistik yang digunakan tidak sesuai jenis data.
Artikel ini akan membongkar secara mendalam setiap tahap pengolahan data: mulai dari pengumpulan, pembersihan, transformasi, hingga analisis. Anda akan menemukan bagaimana setiap keputusan kecil di tahap awal bisa berdampak besar pada hasil penelitian. Bahkan, banyak “rahasia sukses” penelitian yang tak diungkap di kelas metodologi formal dan semua itu akan kita kupas satu per satu.
Apa Itu Pengolahan Data dalam Konteks Penelitian?
Dalam metodologi penelitian, pengolahan data adalah proses sistematis untuk mengubah data mentah menjadi informasi yang bermakna. Proses ini mencakup kegiatan seperti penyuntingan, pengkodean, tabulasi, hingga analisis statistik. Tujuannya bukan sekadar mengorganisasi data, melainkan memastikan bahwa hasil penelitian dapat dipercaya, dapat diulang, dan dapat dipertanggungjawabkan secara ilmiah.
Tanpa tahap pengolahan data yang benar, penelitian menjadi rentan terhadap kesalahan interpretasi. Misalnya, data yang tidak dibersihkan bisa mengandung duplikasi, nilai ekstrem (outlier), atau kesalahan input yang mengacaukan hasil analisis. Karena itu, tahap ini sering disebut sebagai “jembatan” antara pengumpulan data dan interpretasi hasil. Ia menentukan apakah kesimpulan penelitian Anda berdiri di atas fondasi yang kokoh atau rapuh.
Tujuan Utama Pengolahan Data
Tujuan utama dari pengolahan data dalam penelitian adalah menjamin integritas data. Dalam dunia akademik dan ilmiah, data bukan hanya angka atau teks melainkan representasi realitas yang harus diolah dengan objektif. Melalui pengolahan yang sistematis, peneliti dapat mengidentifikasi pola, hubungan antarvariabel, serta anomali yang memerlukan penjelasan lebih lanjut.
Selain itu, proses ini berfungsi untuk menyiapkan data agar siap dianalisis menggunakan teknik statistik, baik deskriptif maupun inferensial. Misalnya, untuk analisis regresi atau korelasi, data numerik harus memenuhi syarat tertentu seperti normalitas dan homogenitas. Proses persiapan ini tidak bisa dilakukan asal-asalan harus ada justifikasi metodologis yang jelas.
Jenis Data yang Perlu Diolah
Dalam praktiknya, ada dua jenis utama data yang sering diolah dalam penelitian: data kualitatif dan data kuantitatif. Data kualitatif bersifat deskriptif, seperti hasil wawancara, catatan lapangan, atau transkrip observasi. Sedangkan data kuantitatif berbentuk angka dan bisa diolah dengan rumus statistik. Namun, tantangan sebenarnya muncul ketika kedua jenis data ini dikombinasikan dalam penelitian mixed methods. Di sinilah kemampuan analisis peneliti diuji: bagaimana menjaga validitas ketika menggabungkan dua dunia yang berbeda.
Prinsip Dasar yang Harus Dipegang
Ada tiga prinsip utama dalam pengolahan data penelitian yang tak boleh diabaikan:
1. **Konsistensi:** Semua langkah pengolahan harus dilakukan secara seragam, dari awal hingga akhir. 2. **Keterlacakan:** Setiap perubahan data harus bisa dijelaskan — siapa yang melakukannya, kapan, dan mengapa. 3. **Transparansi:** Peneliti wajib menjelaskan metode pengolahan secara terbuka dalam laporan akhir, agar dapat diuji ulang oleh pihak lain.
1. Editing (Penyuntingan Data)
Langkah pertama dalam pengolahan data adalah editing, yaitu memeriksa data mentah agar terbebas dari kesalahan dan inkonsistensi. Proses ini penting untuk memastikan kualitas data sebelum masuk ke tahap analisis. Editing mencakup pemeriksaan kelengkapan jawaban, konsistensi antarpertanyaan, serta kejelasan tulisan atau input digital.
Contohnya, jika dalam kuesioner terdapat responden yang menulis usia “200 tahun” atau pendapatan “Rp 0”, peneliti perlu menentukan apakah itu kesalahan input, atau memang data valid yang perlu diberi catatan khusus. Editing bukan hanya soal memperbaiki, tetapi juga soal memahami konteks kesalahan.
2. Coding (Pengkodean Data)
Tahap berikutnya adalah pengkodean data. Ini adalah proses mengubah jawaban kualitatif atau kategorikal menjadi bentuk numerik agar bisa dianalisis secara statistik. Misalnya, jawaban “Laki-laki” dikodekan menjadi 1 dan “Perempuan” menjadi 2. Tujuan coding adalah menyederhanakan dan menstandarkan data.
Namun, banyak peneliti pemula melakukan kesalahan fatal di sini mereka tidak mendokumentasikan kode yang digunakan. Padahal, daftar kode (codebook) adalah dokumen vital dalam riset. Tanpa itu, data menjadi sulit diinterpretasi, bahkan tidak dapat direplikasi.
3. Tabulasi (Pengorganisasian Data)
Setelah data dikodekan, langkah berikutnya adalah tabulasi, yaitu menyusun data dalam tabel atau format yang mudah dibaca. Dalam penelitian kuantitatif, tabulasi membantu peneliti mengidentifikasi pola awal, distribusi frekuensi, dan hubungan antarvariabel. Sedangkan dalam penelitian kualitatif, peneliti mungkin membuat matriks kategori untuk memetakan tema-tema utama.
4. Entry dan Validasi Data
Tahap selanjutnya adalah entri data ke perangkat lunak seperti SPSS, Excel, NVivo, atau Python. Entri ini harus disertai validasi memastikan bahwa tidak ada data ganda, salah kolom, atau hilang. Prinsipnya, “garbage in, garbage out”: jika data yang masuk salah, hasil analisis juga salah.
5. Cleaning (Pembersihan Data)
Tahap terakhir sebelum analisis adalah cleaning. Di sini peneliti menelusuri outlier, data hilang (missing values), dan error input. Dalam pengolahan data penelitian, cleaning sangat menentukan validitas hasil. Proses ini bisa melibatkan teknik statistik seperti winsorizing, imputasi data, atau transformasi logaritmik.
Analisis Data: Dari Angka ke Makna
Tahap analisis merupakan puncak dari seluruh proses pengolahan data. Di sinilah data mentah “berbicara”. Peneliti menggunakan teknik statistik atau tematik untuk mengidentifikasi pola, hubungan, dan tren. Dalam penelitian kuantitatif, analisis bisa mencakup regresi, korelasi, ANOVA, atau uji-t. Sementara dalam penelitian kualitatif, analisis dilakukan dengan coding tematik atau analisis naratif.
Namun, penting diingat: analisis bukan sekadar menjalankan software statistik. Banyak peneliti tergoda untuk “menekan tombol” SPSS atau R tanpa memahami asumsi di baliknya. Padahal, hasil analisis yang valid harus didasarkan pada logika metodologis, bukan sekadar output komputer.
Transformasi Data
Transformasi data adalah proses mengubah format atau skala data agar sesuai dengan kebutuhan analisis. Misalnya, mengubah data ordinal menjadi interval, atau menormalkan distribusi data agar memenuhi syarat analisis parametrik. Tahap ini juga termasuk penggabungan variabel (aggregation) dan standarisasi.
Transformasi sering disalahpahami sebagai “memanipulasi” data. Padahal, jika dilakukan dengan benar dan transparan, transformasi justru memperkuat validitas hasil penelitian. Prinsipnya: setiap transformasi harus dijelaskan dengan alasan ilmiah yang jelas.
Interpretasi: Menghubungkan Data dengan Teori
Setelah hasil diperoleh, peneliti harus mengaitkan temuan dengan kerangka teori atau hipotesis awal. Di sinilah kemampuan berpikir kritis diuji. Hasil statistik tanpa interpretasi ibarat peta tanpa kompas. Proses ini juga membantu menilai apakah hasil penelitian mendukung atau menolak hipotesis.
Menjaga Validitas dan Reliabilitas
Dalam pengolahan data penelitian, dua istilah penting selalu muncul: validitas dan reliabilitas. Validitas memastikan bahwa data benar-benar mengukur apa yang seharusnya diukur, sedangkan reliabilitas memastikan hasilnya konsisten bila diuji ulang. Keduanya menjadi dasar dari keilmiahan sebuah penelitian.
Untuk menjaga validitas, peneliti dapat menggunakan triangulasi membandingkan data dari berbagai sumber atau metode. Sedangkan untuk reliabilitas, dilakukan uji konsistensi seperti Cronbach’s Alpha (untuk kuesioner) atau inter-rater reliability (untuk data kualitatif).
Menghindari Bias dalam Pengolahan Data
Bias adalah musuh terbesar penelitian. Bias bisa muncul dari cara data dikumpulkan, dipilih, bahkan diolah. Dalam pengolahan data, bias sering terjadi saat peneliti tanpa sadar “memilih” data yang mendukung hipotesisnya saja. Untuk menghindarinya, gunakan prosedur objektif, laporkan seluruh hasil (termasuk yang tidak signifikan), dan dokumentasikan setiap keputusan analisis.
Etika Pengolahan Data
Etika juga menjadi aspek vital. Data harus dijaga kerahasiaannya, terutama jika melibatkan subjek manusia. Peneliti tidak boleh mengubah atau menghapus data untuk “memperindah” hasil. Dalam dunia akademik, integritas adalah segalanya. Melanggar etika pengolahan data sama saja dengan menghancurkan reputasi ilmiah.
Output Akhir dan Pelaporan
Tahap terakhir adalah menyajikan hasil pengolahan data secara transparan dalam laporan penelitian. Peneliti harus mencantumkan metode pengolahan, perangkat lunak yang digunakan, dan alasan pemilihan teknik analisis. Pelaporan yang jujur memungkinkan pembaca atau peneliti lain mereplikasi penelitian dengan hasil yang sebanding.
Daftar Pustaka
-
Martins, A., Pereira, R., Silva, J., & Abreu, P. (2025). Performance and scalability of data cleaning and preprocessing tools: A benchmark on large real-world datasets. Data, 10(5), 68. https://doi.org/10.3390/data10050068 MDPI
-
Côté, P.-O., Nikanjam, A., Ahmed, N., Humeniuk, D., & Khomh, F. (2024). Data cleaning and machine learning: A systematic literature review. Automated Software Engineering, 31, 54. https://doi.org/10.1007/s10515-024-00453-w SpringerLink
-
Rao, K. M., Saikrishna, G., & Supriya, K. (2023). Data preprocessing techniques: Emergence and selection towards machine learning models—A practical review using HPA dataset. Multimedia Tools and Applications, 82, 37177–37196. https://doi.org/10.1007/s11042-023-15087-5 SpringerLink
-
Fadele, A. A., & Rocha, A. (2025). Quantitative research data preparation and cleaning process. In The Art and Science of Quantitative Research (pp. 155–184). Springer. https://doi.org/10.1007/978-3-031-91431-7_6 SpringerLink+2SpringerLink+2
-
Proudfoot, K. (2022). Inductive/deductive hybrid thematic analysis in mixed methods research. Journal of Mixed Methods Research. https://doi.org/10.1177/15586898221126816 ResearchGate+1
-
Guo, J., Lyu, T., Wang, Y., Zhang, H., & Li, X. (2023). Normal workflow and key strategies for data cleaning in real-world research. Interactive Journal of Medical Research, 12(1), e44310. https://doi.org/10.2196/44310 i-jmr.org
-
Liu, M., Li, S., Yuan, H., Ong, M. E. H., Ning, Y., Xie, F., … Liu, N. (2023). Handling missing values in healthcare data: A systematic review of deep learning-based imputation techniques. Artificial Intelligence in Medicine, 145, 102695. https://arxiv.org/abs/2210.08258 arXiv+1
-
Emmanuel, T., Maupong, T., Mpoeleng, D., Semong, T., Mphago, B., & Tabona, O. (2021). A survey on missing data in machine learning. Journal of Big Data, 8, 140. https://doi.org/10.1186/s40537-021-00516-9 SpringerOpen
-
Martins, P., Cardoso, F., Vaz, P., & Silva, J. (2024). Data cleaning and ML: State of the art and emerging challenges (review). Automated Software Engineering—Supplementary insights. https://link.springer.com/article/10.1007/s10515-024-00453-w SpringerLink
-
Okorie, C., Udeh, S., Adaga, T., DaraOjimba, C., & Oriekhoe, B. (2024). Ethical considerations in data collection and analysis: A review investigating ethical practices and challenges. International Journal of Applied Research in Social Sciences, 6(1), 1–22. https://doi.org/10.51594/ijarss.v6i1.688 ResearchGate
-
Pilowsky, J. K., Elliott, R., Wallace, J., & Bottacin, T. (2024). Data cleaning for clinician researchers: Application and explanation of a data-quality framework. Australian Critical Care, 37(4), 380–386. https://www.australiancriticalcare.com/article/S1036-7314(24)00058-4/fulltext australiancriticalcare.com
-
(Tampere University Library) Fält, K. (2021). Research data management and ethics (guide). Tampere University. https://research.tuni.fi/app/uploads/2021/05/7a80823d-research-data-management-and-ethics_20210517.pdf research.tuni.fi
-
Journal of Advanced Nursing (Jia, A. M. S., Kpormegbey, D. E., …). (2025). A primer of data cleaning in quantitative research: Handling missing values and outliers. Journal of Advanced Nursing. https://doi.org/10.1111/jan.16908 Wiley Online Library+1
-
Portela, M., Sousa, R., & Moreira, A. C. (2023). Using advanced mixed methods approaches: Combining PLS-SEM and qualitative studies. Journal of Business Research, 169, 114165. (Author-accepted manuscript) https://researchportal.port.ac.uk/files/82579775/Using_advanced_mixed_methods_approaches.pdf University of Portsmouth
-
Hasan, M., & Rahman, M. (2025). Using thematic analysis in qualitative research: Steps and a 16-item rigor checklist. MethodsX, 12, 103456. https://www.sciencedirect.com/science/article/pii/S2949916X25000222 ScienceDirect
What's Your Reaction?